Plataforma de agentes de IA para empresas: el diseño de la arquitectura
Estoy diseñando una plataforma que conecta Excel, bases de datos, APIs y documentos, y responde en lenguaje natural diciendo de dónde sale cada cifra. Está en construcción, en fase 0: esta página describe el diseño.
Qué es y en qué estado está
La plataforma de agentes de IA para empresas está en construcción, en fase 0: arquitectura. Todavía no hay código publicado. Esta página describe el diseño que definí, no un producto que se pueda usar hoy.
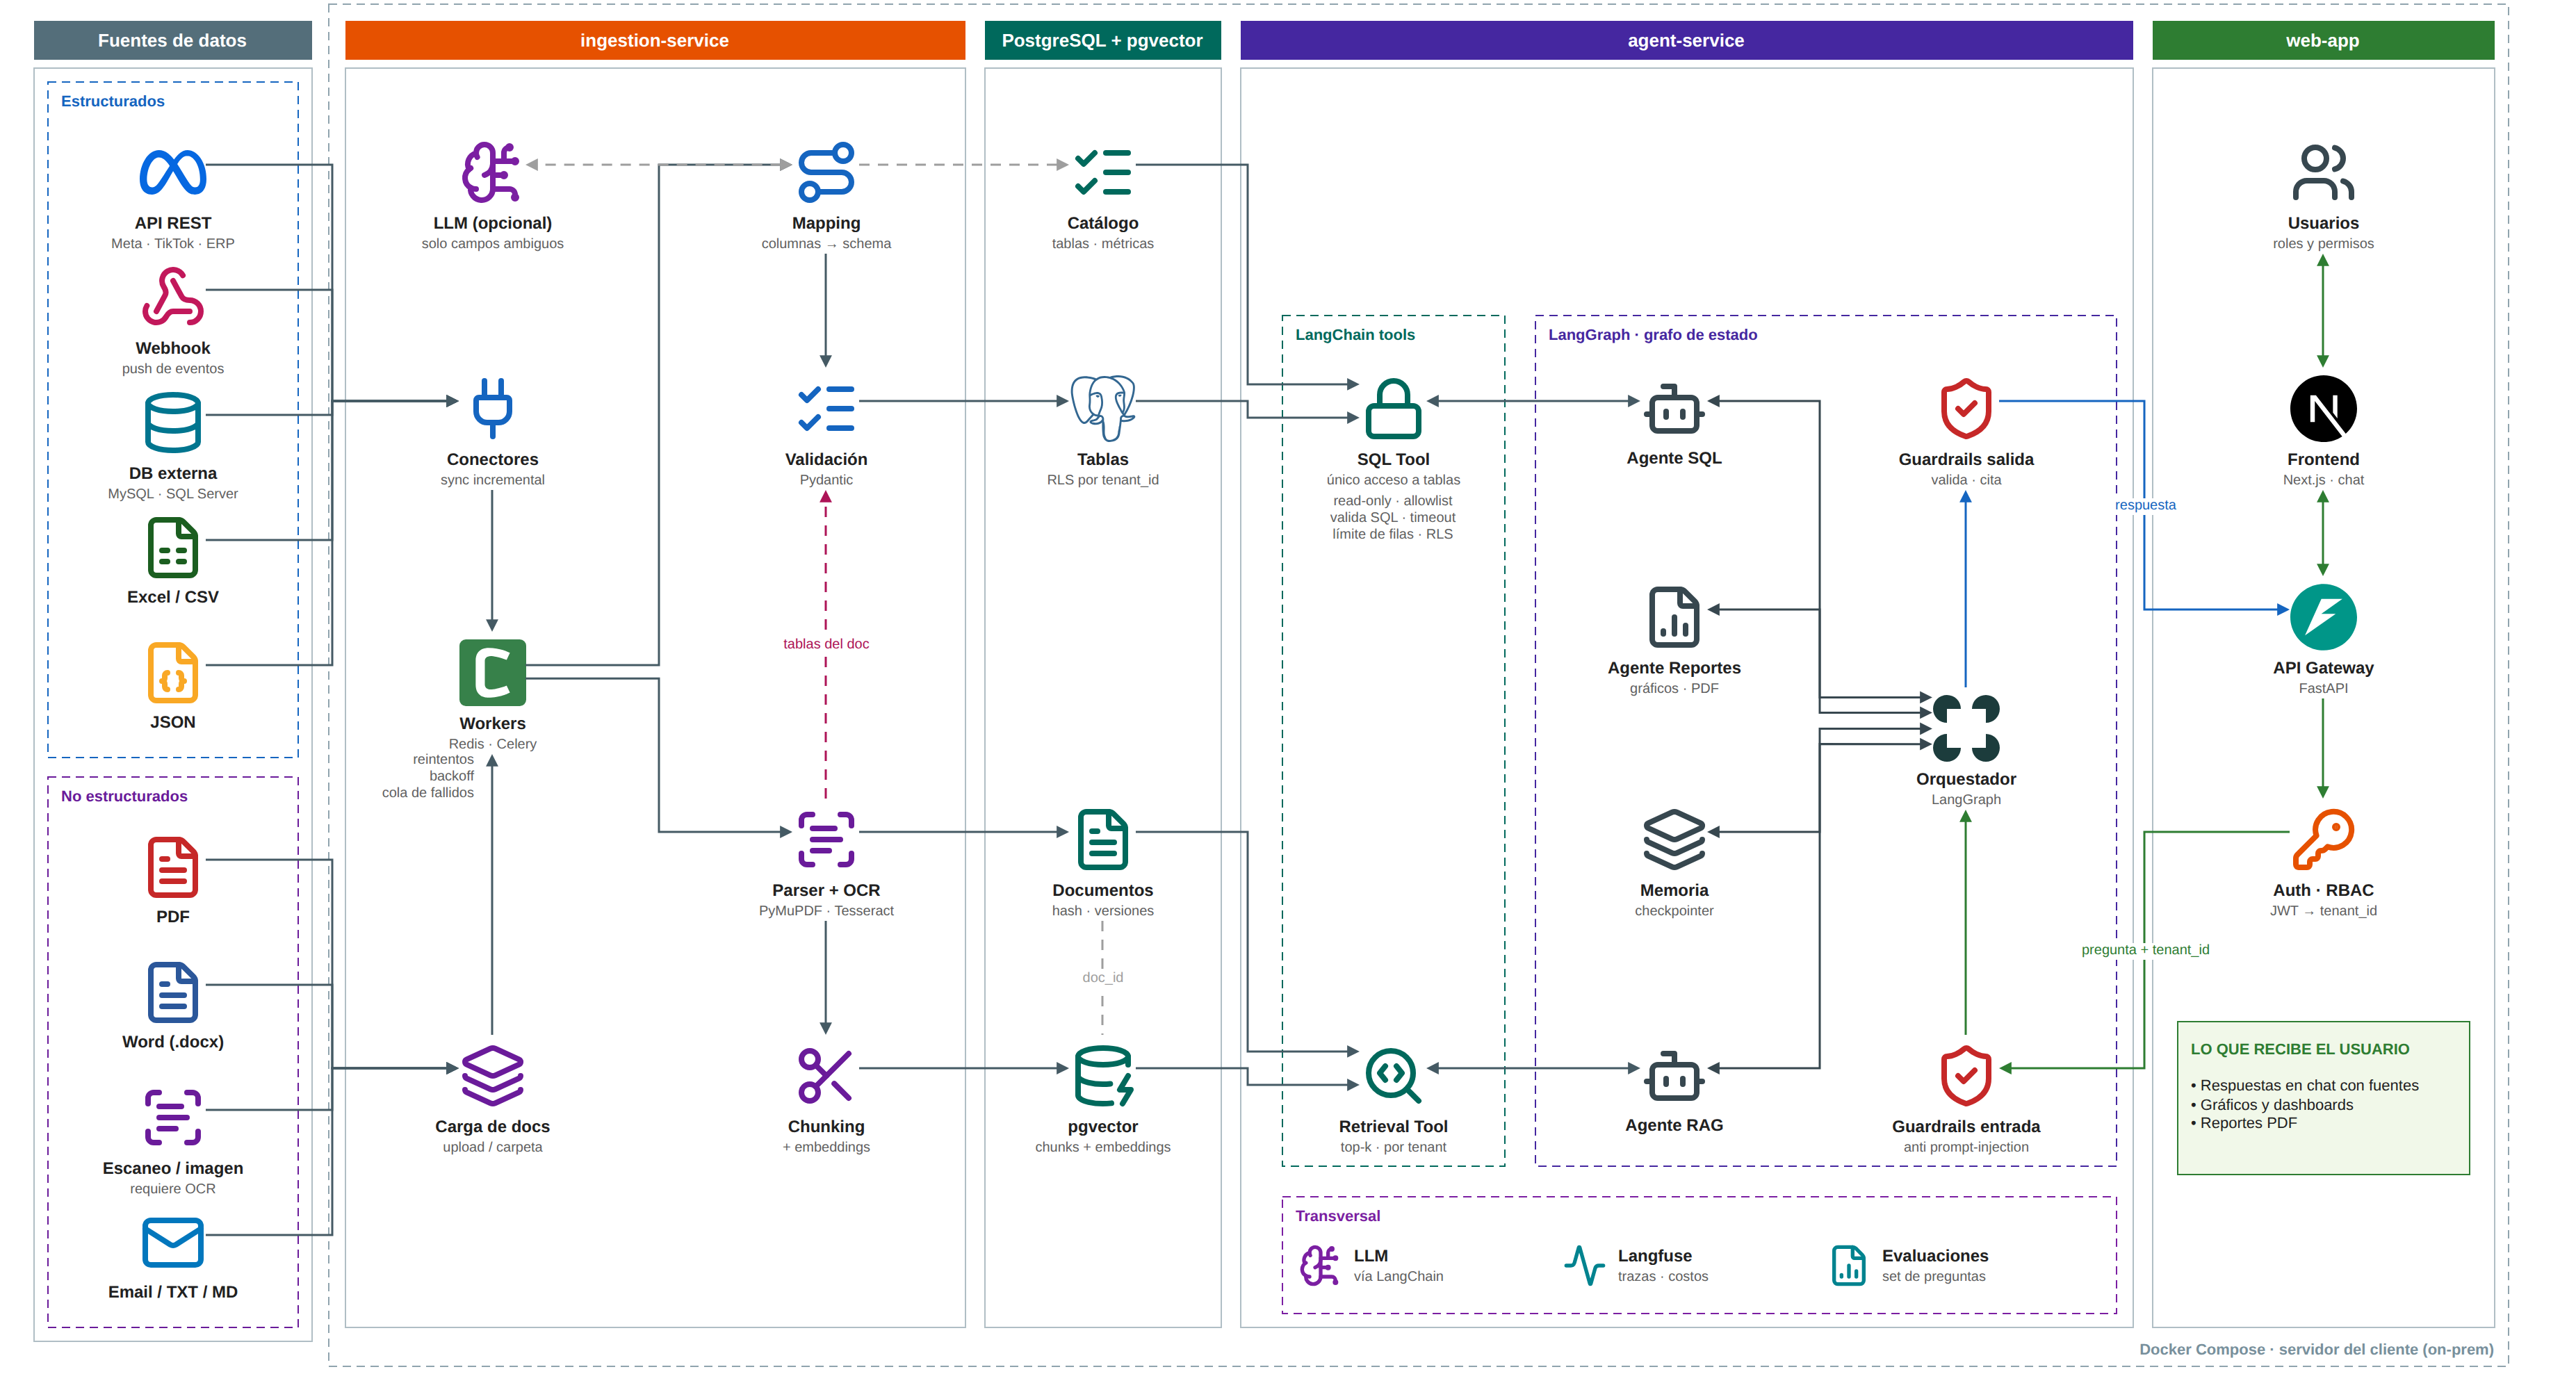
El diseño está documentado con un modelo C4, un diagrama de secuencia y 10 ADRs. El diagrama de arquitectura completo se puede abrir a tamaño completo más abajo.
El problema que resuelve
La información de una empresa está repartida entre planillas de Excel, bases de datos, APIs y documentos. La plataforma se propone conectar esas fuentes y contestar preguntas en lenguaje natural indicando, en cada respuesta, de dónde sale cada cifra.
Lo que la persona recibe en el chat son respuestas con sus fuentes, gráficos y dashboards, e informes en PDF.
Arquitectura
Son cuatro piezas: un servicio de ingesta, una base PostgreSQL con pgvector, un servicio de agentes y una aplicación web. La capa transversal agrega el LLM vía LangChain, trazas y costos con Langfuse, y evaluaciones sobre un conjunto de preguntas.
- Stack previsto: Python, LangGraph, LangChain, FastAPI, PostgreSQL con pgvector, Langfuse, Next.js y Docker.
- Despliegue previsto: Docker Compose en el servidor propio del cliente (on-prem).
- Aplicación web: un frontend de chat en Next.js, un API gateway en FastAPI, autenticación y RBAC con un JWT que lleva el tenant_id, y usuarios con roles y permisos.
Fuentes de datos e ingesta
Las fuentes estructuradas son APIs REST, webhooks, bases externas (MySQL y SQL Server), Excel y CSV, y JSON. Las no estructuradas son PDF, Word, escaneos e imágenes que necesitan OCR, y correo, TXT y MD.
- Conectores con sincronización incremental.
- Workers sobre Redis y Celery, con reintentos, backoff y una cola de trabajos fallidos.
- Mapeo de columnas al esquema, usando un LLM opcional solo para los campos ambiguos.
- Validación con Pydantic.
- Parser y OCR con PyMuPDF y Tesseract, y luego chunking y embeddings.
- Carga de documentos.
La parte de IA: el servicio de agentes
El servicio de agentes expone dos herramientas de LangChain. La SQL Tool es el único acceso a las tablas. La Retrieval Tool recupera los top-k fragmentos, siempre dentro de un tenant.
Sobre ellas hay un grafo de estados de LangGraph: un orquestador deriva cada pregunta al agente de SQL, al agente de informes (gráficos y PDF) o al agente de RAG. La memoria usa un checkpointer.
Confiabilidad y seguridad previstas
- La SQL Tool es de solo lectura: lista blanca, SQL validado, timeout, límite de filas y RLS.
- Las tablas llevan RLS por tenant_id, y la Retrieval Tool también recupera por tenant.
- Un guardrail de entrada contra prompt injection y un guardrail de salida que valida y cita.
- Los documentos se guardan con hash y versiones.
- Langfuse registra trazas y costos, y se evalúa sobre un conjunto de preguntas.
Qué está definido y qué no
- Definido: la arquitectura, documentada con un modelo C4, un diagrama de secuencia y 10 ADRs.
- No existe todavía: el código. No hay repositorio público, no hay demo y no hay métricas, porque no hay nada que medir.
- Todo lo anterior es diseño. Cuando haya una primera versión funcionando, esta página se va a actualizar con lo que se haya medido.
Stack
- Python
- LangGraph
- LangChain
- FastAPI
- PostgreSQL + pgvector
- Langfuse
- Next.js
- Docker