AgendaGo: un SaaS de turnos con tres agentes de IA en producción
Diseñé y opero AgendaGo, un SaaS de turnos multi-negocio. Este caso explica cómo funcionan sus tres agentes de IA, qué barreras tienen y cómo los evalúo y los mido.
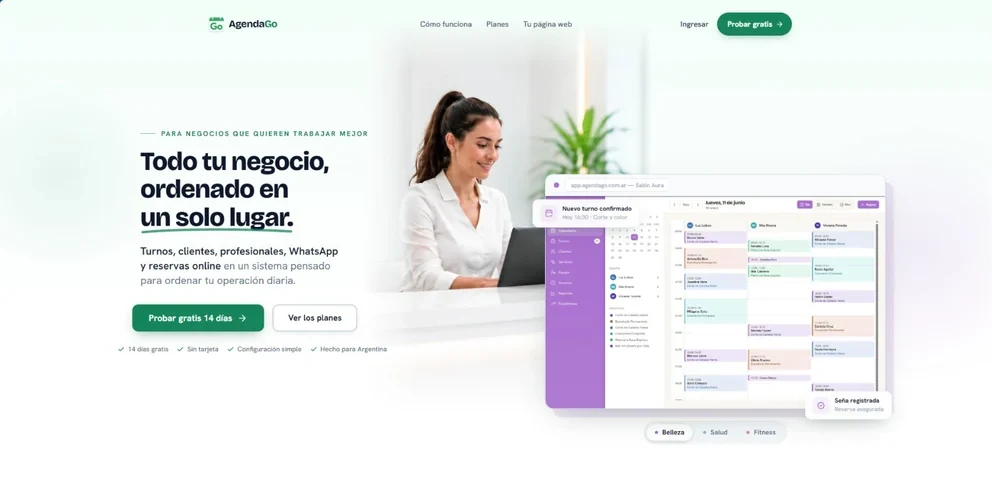
Qué es y en qué estado está
AgendaGo es un SaaS de turnos multi-negocio: cada negocio configura su agenda y sus clientes reservan. Está en producción en agendago.com.ar. Lo diseñé y lo opero yo, y sobre el sistema de turnos construí tres agentes de IA con tool calling.
Este caso describe la parte de ingeniería de IA: cómo se limita lo que un modelo puede hacer, cómo se evalúa y qué se mide en cada llamada.
El problema que resuelve
Un negocio que vive de turnos tiene tareas que se repiten todos los días. Cada agente de AgendaGo toma una de ellas:
- Configurar el sistema: servicios, horarios y reglas. Lo hace el asistente del panel, a pedido del dueño.
- Atender y agendar por WhatsApp. Lo hace el agente de WhatsApp, con el cliente final.
- Cargar stock a partir de las facturas y remitos de proveedores. Lo hace la lectura con visión.
Arquitectura
El frontend es React con TypeScript, Vite, Tailwind y shadcn/ui. El backend vive en Supabase: PostgreSQL con RLS y Edge Functions. Las integraciones externas son la WhatsApp Cloud API y MercadoPago.
La IA corre en Edge Functions y llama a OpenAI por HTTP directo, sin SDK, detrás de una capa de abstracción de proveedor. La respuesta viaja en streaming desde la Edge hasta el frontend, así que el dueño ve el texto mientras se genera.
Asistente del panel: propone, y una persona aprueba
El asistente del panel tiene 21 herramientas: 11 de lectura, 2 de simulación o explicación y 8 de propuesta. Las de propuesta nunca escriben. Crean una propuesta con el diff y su consecuencia, que vence a los 15 minutos, y un clic humano la aplica.
Aplicar la propuesta no depende de que el modelo se porte bien: lo hace cumplir la base de datos. Es una función SECURITY DEFINER, solo para el rol admin, con bloqueo de fila y un paso atómico que aplica y marca la propuesta como aplicada.
- Tres niveles de confirmación, derivados del riesgo de cada acción. Las destructivas piden confirmación explícita y no pueden ir en un lote.
- Por turno: como máximo 4 rondas de herramientas del modelo y 700 tokens, más un tope de gasto por turno.
- Un presupuesto mensual por negocio, y las ejecuciones se pueden cancelar.
Agente de WhatsApp: tres barreras antes de agendar
El agente de WhatsApp tiene 9 herramientas: disponibilidad, reserva, horarios, dirección, servicios, cobertura, requisitos, repregunta y derivación a una persona.
Reservar tiene tres barreras, y ninguna depende de lo que diga el modelo:
- El horario tiene que salir del motor de disponibilidad en el mismo turno.
- El cliente no puede tener ya una reserva ese día.
- Un trigger de la base bloquea el sobreturno como último cierre.
Todo lo que sale hacia el cliente pasa por una única vía de envío, que aplica la ventana de 24 horas y las plantillas de WhatsApp. Un router determinista responde alrededor del 44% de los mensajes sin llamar al modelo. La app pasó la revisión de Meta el 31 de agosto de 2026.
Visión: facturas y remitos de proveedores
El modelo lee facturas y remitos de proveedores para actualizar el stock. Extrae proveedor, número, fecha, total y renglones, y el prompt le indica usar null y nunca inventar un dato.
- Una validación determinista limita renglones y largos y exige una ventana de fechas.
- El cruce con el catálogo lo hace código determinista, no el modelo.
- Lo leído va a un área de preparación: el stock se mueve solo cuando una persona confirma.
- Un bloqueo por sha256 impide subir dos veces el mismo archivo. Los PDF con capa de texto usan extracción de texto en lugar de visión.
- El texto dentro de un archivo se trata como dato, no como instrucción: es la defensa contra prompt injection.
Evaluación y telemetría
Para el asistente del panel hay un dataset de 100 frases con la herramienta esperada por cada una, más chequeos deterministas en CI. Para WhatsApp hay un dataset de 52 escenarios y 15 conversaciones, con categorías como saludo, precio, reserva, ambigüedad, adversarial y prompt injection. Cada escenario declara la ruta esperada, los criterios y lo que el agente no debe hacer.
Los evals con modelo corren contra el stack real, con un tope de gasto, y existe un script de juez a ciegas.
La tabla ai_usage_log guarda por cada llamada: negocio, agente, usuario, modelo, versión del prompt, tokens de entrada, salida y caché, costo en dólares, latencia, intención, herramientas usadas y resultado (ok, fallback, derivación, error, presupuesto agotado, guardrail o modelo rechazó). No guarda texto de clientes. Si el insert falla, el turno se corta; un test exige que cada insert declare modelo y versión de prompt, y los prompts están versionados en el repositorio.
Confiabilidad y seguridad
- Lista blanca de herramientas, filtrada por rol.
- El negocio sale del JWT, nunca del modelo. Los parámetros prohibidos (ids de negocio, tokens, banderas de admin) se descartan.
- El texto de clientes y de archivos se envuelve como dato.
- Un detector de entidades inventadas y la procedencia de cada afirmación.
- El texto de rechazo lo arma el código, no el modelo.
- Límite de tasa en el borde y un único control en la base para el presupuesto mensual.
- RLS de Postgres habilitado en todo el esquema, y RPC SECURITY DEFINER con search_path fijo.
- La suite tiene 522 archivos de test.
Qué está en producción y qué no
Todo lo descrito en esta página está en producción: los tres agentes, los evals y la telemetría. Lo que sigue en construcción no es de AgendaGo: es Nux, el asistente de Bonuxo, y la plataforma de agentes de IA para empresas, que está en fase 0 de arquitectura.
Stack
- React
- TypeScript
- Vite
- Tailwind
- shadcn/ui
- Supabase (PostgreSQL, RLS, Edge Functions)
- OpenAI
- WhatsApp Cloud API
- MercadoPago